02.9 확률의 정의와 성질
이 장에서는 확률의 수학적·실험적·기하학적 정의와 기본 공리를 학습하고, 시행 횟수가 늘어남에 따라 표본 평균이 참 확률에 수렴하는 대수의 법칙(큰 수의 법칙)을 통해 강화학습 전이 확률(Transition Probability)의 수학적 기초를 다집니다.
👧 도로시: “지니! 격자 세상 게임판 위에서 캐릭터에게 위로 전진하라고 명령을 내렸는데, 갑자기 바람이 쌩 불어서 옆 칸으로 미끄러져 버렸어!”
🐱 지니: “그게 바로 우리가 사는 현실 환경의 확률적 불확실성이란다! 주사위처럼 모든 결과의 확률 합은 일백 퍼센트가 되고, 대수의 법칙에 따라 반복할수록 참 확률에 다가서게 되지!”
02.9.1 확률의 뜻과 상태 전이 확률
확률이란 불확실한 결과를 객관적이고 체계적인 수치로 다루기 위한 수학적 도구입니다.
“지니! 격자 세상(Grid World) 게임판 위에서 캐릭터에게 ‘위로 전진해!’ 하고 명령을 내렸는데, 갑자기 바람이 쌩 불어서 옆 칸으로 미끄러져 버렸어! 내가 원하는 방향으로 갈 확률은 정확히 몇 퍼센트인 거야?”
도로시가 조이패드를 쥔 채 곤란한 표정으로 격자 지도를 바라보며 물었습니다.
토토도 멍멍 짖으며 바람 소리에 맞춰 고개를 갸우뚱거렸습니다.
 그림 02-9-1 격자 세상에서 조이패드를 쥐고 전진 명령 시 바람으로 인한 이동 확률을 고민하는 도로시와 토토
지니는 요술봉을 휘둘러 허공에 바람의 방향과 전이 확률 지도를 입체로 띄워 주었습니다.
“도로시! 강화학습 환경에서는 행동(Action)을 취했을 때 100% 확정적으로 목표 칸에 도달하지 못하고 외부 요인(바람, 마찰)에 의해 다른 상태로 이탈할 수 있단다. 이때 특정 행동 후 다음 상태에 도달할 가능성을 수치화한 것을 상태 전이 확률(Transition Probability)이라고 부르지.”
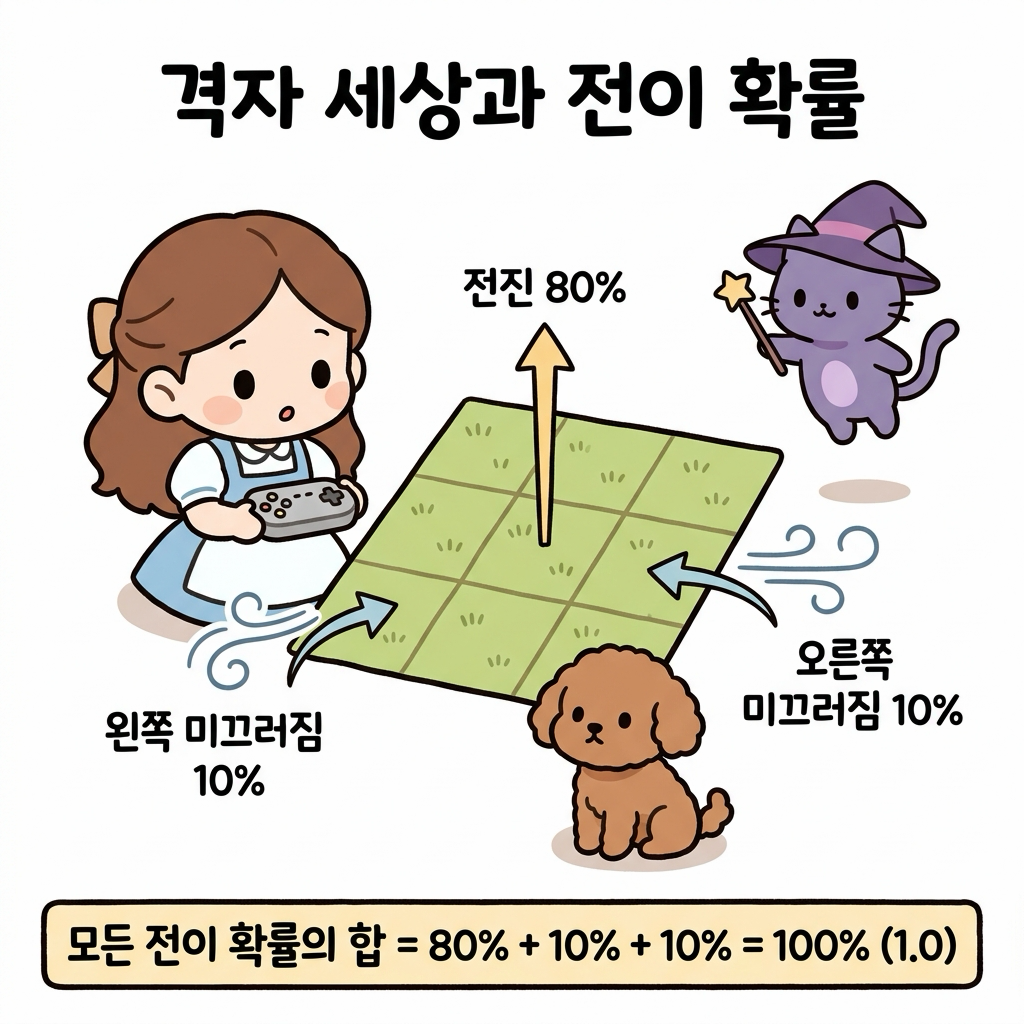 그림 02-9-2 격자 세상에서 이동 명령을 내렸을 때 전진 성공(80%)과 좌우 미끄러짐(각 10%)의 전이 확률 시스템을 살펴보는 도로시와 지니, 토토
“아! 전진할 성공 확률이 0.8(80%)이고, 양옆으로 미끄러질 확률이 각각 0.1(10%)씩 배정되어 있구나! 세 숫자를 다 더하면 정확히 1.0(100%)이 되네!”
도로시가 환하게 웃으며 외쳤습니다.
지니가 칠판을 가리키며 덧붙였습니다.
“맞아! 어떤 상태에서 어떤 행동을 하든, 이동 가능한 모든 다음 상태들의 전이 확률을 전부 합산하면 항상 1.0(100%)이 되어야 한다는 것이 확률의 가장 중요한 절대 공리란다.”
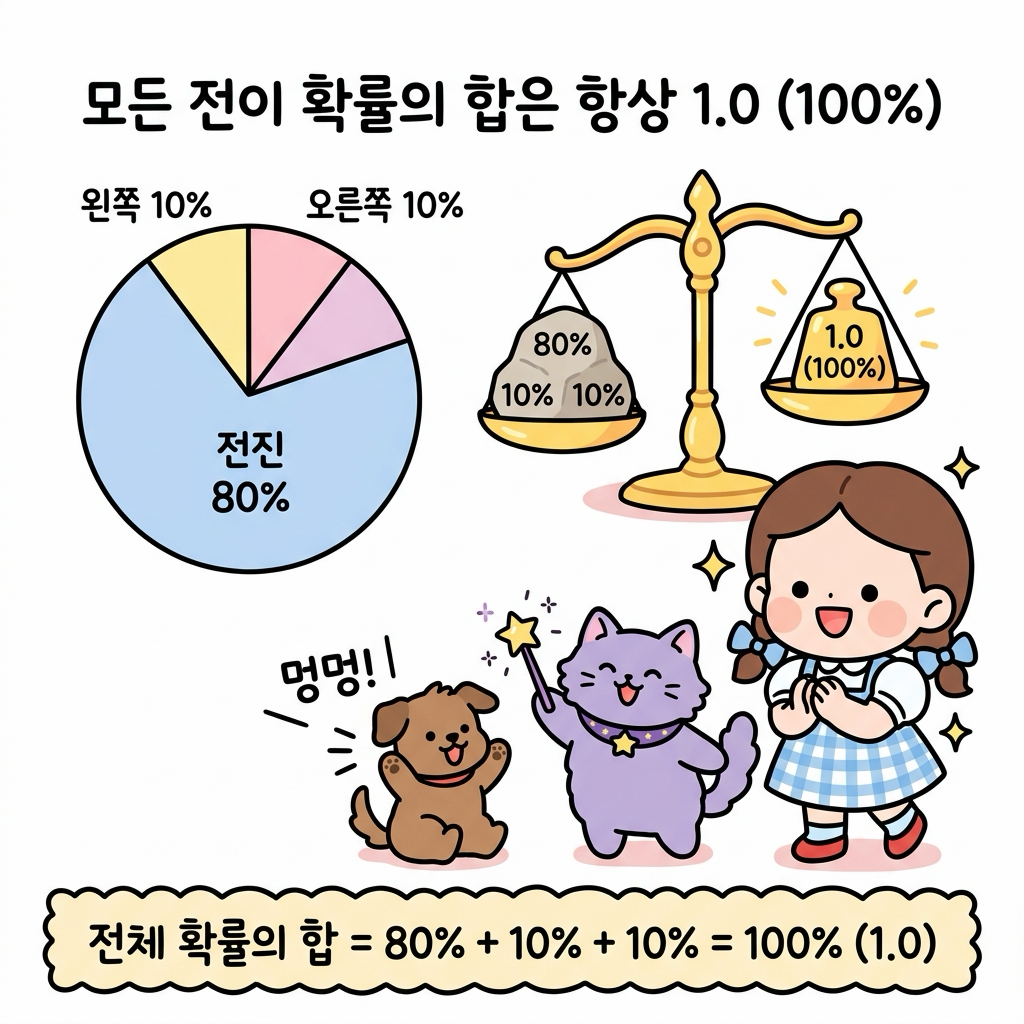 그림 02-9-3 전진(80%)과 좌우 미끄러짐(각 10%)의 모든 전이 확률을 합산하면 항상 완벽한 1.0(100%) 균형을 이룸을 깨닫는 도로시와 지니, 토토
2.9.1.1 확률의 기본 성질과 콜모고로프 공리계
1933년 러시아의 대수학자 안드레이 콜모고로프(Andrey Kolmogorov)는 확률 이론을 현대 수학의 엄밀한 체계로 완성하기 위해 다음과 같은 세 가지 기본 공리(Axioms of Probability)를 정립했습니다.
 그림 02-9-4 1933년 확률론의 기초를 정립하여 현대 확률의 3대 공리를 완성한 수학자 안드레이 콜모고로프와 지니, 도로시
전체 표본공간 S와 임의의 사건 A에 대해 다음 세 가지 핵심 성질들이 반드시 성립합니다.
1. 비음수성 (Non-negativity)
어떤 사건 A가 일어날 확률도 결코 음수가 될 수 없으며, 0(0%) 이상 1(100%) 이하의 실수로 정의됩니다.
\[0 \le P(A) \le 1\]- 주사위 비유와 성립 원리:
- 주사위 1개를 던질 때 나타날 수 있는 전체 경우의 수는 6가지(n(S) = 6)입니다.
- 우리가 관찰하고자 하는 특정 사건 A(예: 짝수의 눈)의 경우의 수 n(A)는 최소 0개(어떤 눈도 안 나옴)에서 최대 6개(모든 눈이 해당됨) 사이일 수밖에 없습니다.
- 따라서 0 ≤ n(A) ≤ n(S) 가 성립하며, 전체 경우의 수 n(S)로 양변을 나누면 확률은 반드시 0과 1 사이의 값이 됩니다: \(0 \le \frac{n(A)}{n(S)} \le 1 \implies 0 \le P(A) \le 1\)
- 현실 세계에서 ‘주사위를 던져 짝수가 -1번 나온다(음수 확률)’거나 ‘6번 중 7번 발생한다(100% 초과)’는 것은 물리적으로 불가능합니다.
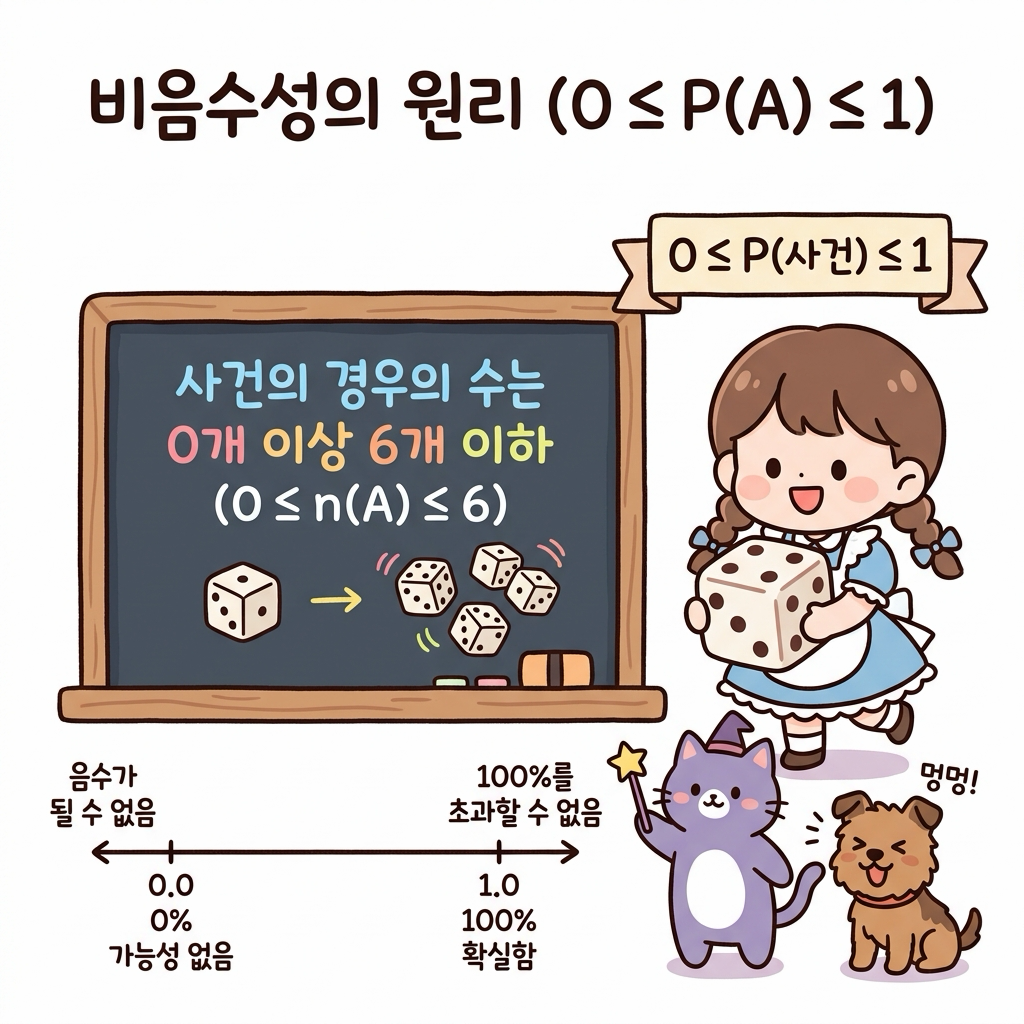 그림 02-9-5 주사위 6개의 면 중 사건에 해당하는 면의 수는 0개 이상 6개 이하이므로 확률은 결코 음수가 될 수 없고 1.0(100%)을 넘을 수 없음을 설명하는 도로시와 지니, 토토
2. 전체 사건의 확률 (정규화, Normalization)
시행을 했을 때 어떤 결과든 표본공간 S 안에서는 반드시 발생하므로, 전사건(전체 표본공간 S)의 확률은 항상 1(100%)입니다.
\[P(S) = 1\]- 주사위 비유와 성립 원리:
- 주사위 1개를 던졌을 때 1, 2, 3, 4, 5, 6 중 어느 하나의 눈은 100% 무조건 나오게 됩니다.
- 각각의 눈이 나올 확률은 1/6씩 동등하며, 표본공간을 이루는 6개의 모든 상호 배반적인 근원사건들의 확률을 전부 합산하면 정확히 1.0이 됩니다: \(P(S) = P(1) + P(2) + P(3) + P(4) + P(5) + P(6) = \frac{1}{6} \times 6 = \frac{6}{6} = 1.0\ (100\%)\)
- 강화학습에서도 에이전트가 어떤 상태에서 행동을 취했을 때 전이될 수 있는 모든 다음 상태 확률들의 합이 항상 1.0이 되는 이유가 바로 이 정규화 공리 때문입니다.
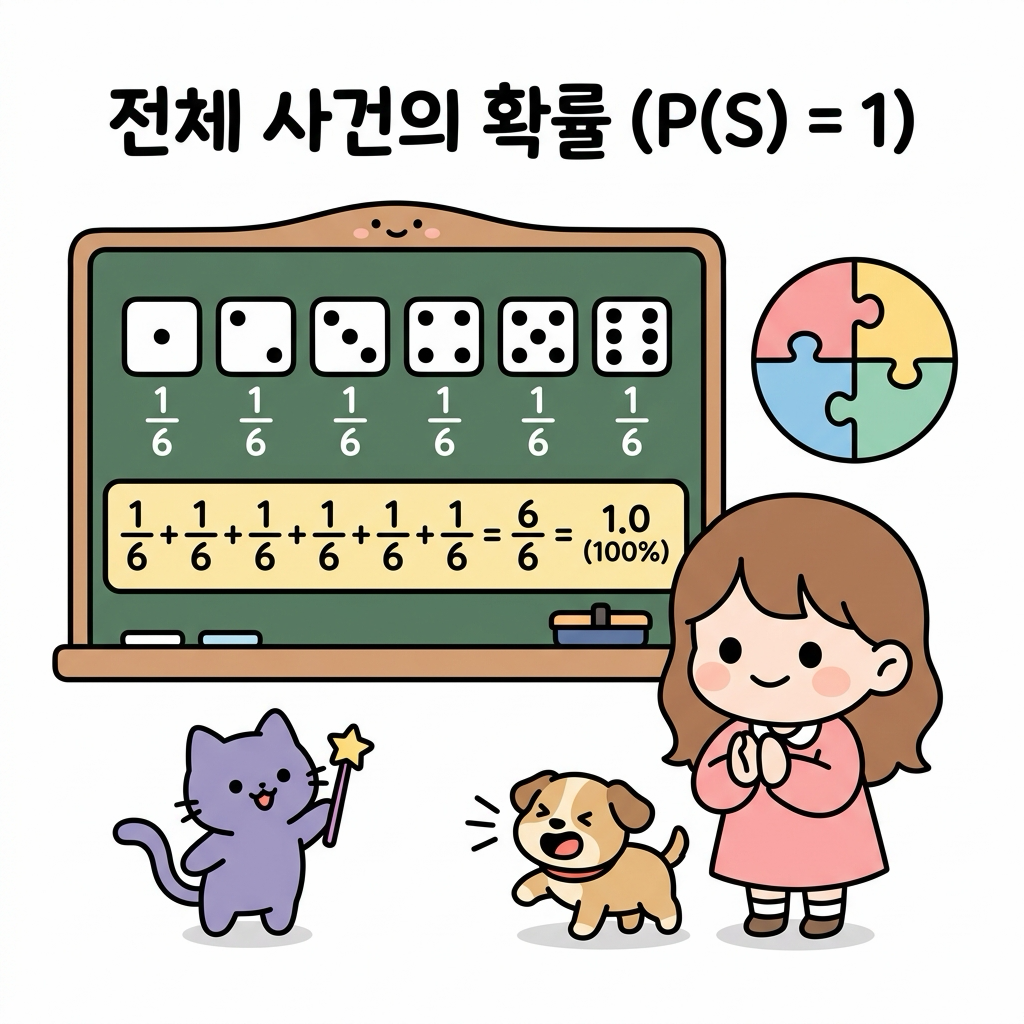 그림 02-9-6 주사위의 6개 눈이 나올 각각의 확률(1/6)을 모두 더하면 전체 확률의 합이 정확히 1.0(100%)을 이룸을 나타낸 시각화
3. 공사건의 확률 (Empty Set)
표본공간에 어떤 원소도 포함하지 않아 결코 일어날 수 없는 빈 사건인 공사건(空事件, ∅)의 확률은 항상 0(0%)입니다.
\[P(\emptyset) = 0\]- 주사위 비유와 성립 원리:
- 1부터 6까지 적힌 일반 주사위를 던졌을 때 ‘7의 눈이 나올 사건’이나 ‘동시에 1이면서 2인 눈이 나올 사건’을 생각해 봅시다.
- 이 사건에 해당하는 경우의 수는 n(∅) = 0개이므로, 일어날 확률은 0이 됩니다: \(P(\text{7의 눈}) = \frac{n(\emptyset)}{n(S)} = \frac{0}{6} = 0\ (0\%)\)
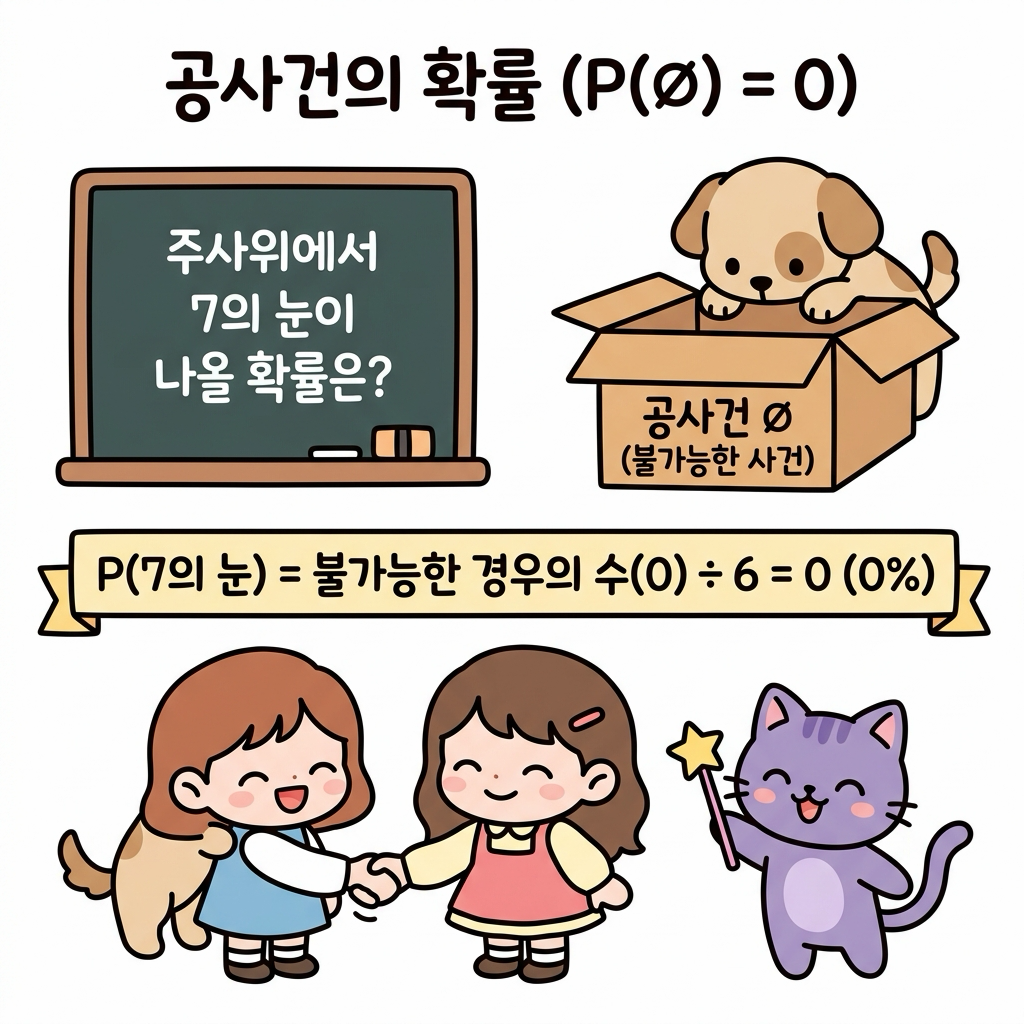 그림 02-9-7 주사위에서 7의 눈이 나오는 것과 같이 표본공간에 존재하지 않아 일어날 가능성이 전혀 없는 빈 상자(공사건 ∅)의 확률이 0임을 설명하는 지니와 도로시, 토토
02.9.2 확률을 정의하는 세 가지 관점
확률은 문제를 바라보는 대상과 실험 환경에 따라 크게 세 가지 관점으로 정의됩니다.
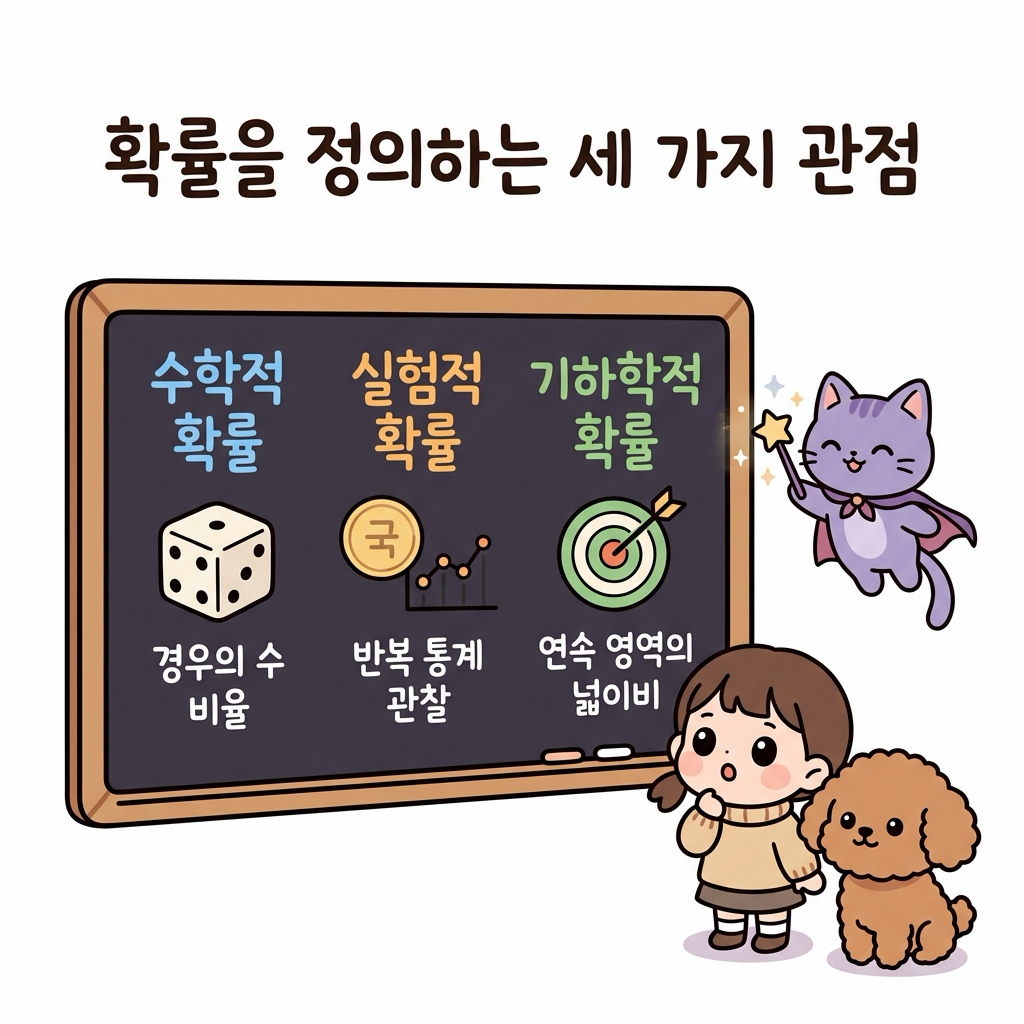 그림 02-9-8 경우의 수 비율로 계산하는 수학적 확률, 반복 실험으로 수렴하는 실험적 확률, 연속 영역의 크기로 구하는 기하학적 확률의 3대 정의를 비교 설명하는 지니와 도로시, 토토
2.9.2.1 수학적 확률 (고전적 확률)
표본공간 S의 각 원소(근원사건)가 일어날 가능성이 모두 동등할 때(Equally likely), 전체 경우의 수 중 사건 A가 일어나는 경우의 수의 비율로 정의합니다.
\[P(A) = \frac{n(A)}{n(S)} = \frac{\text{사건 } A\text{가 일어나는 경우의 수}}{\text{모든 가능한 경우의 수}}\]- 대표 예시: 주사위 1개를 던질 때 소수의 눈(2, 3, 5)이 나올 확률: \(P(\text{소수}) = \frac{3}{6} = \frac{1}{2} = 0.5\)
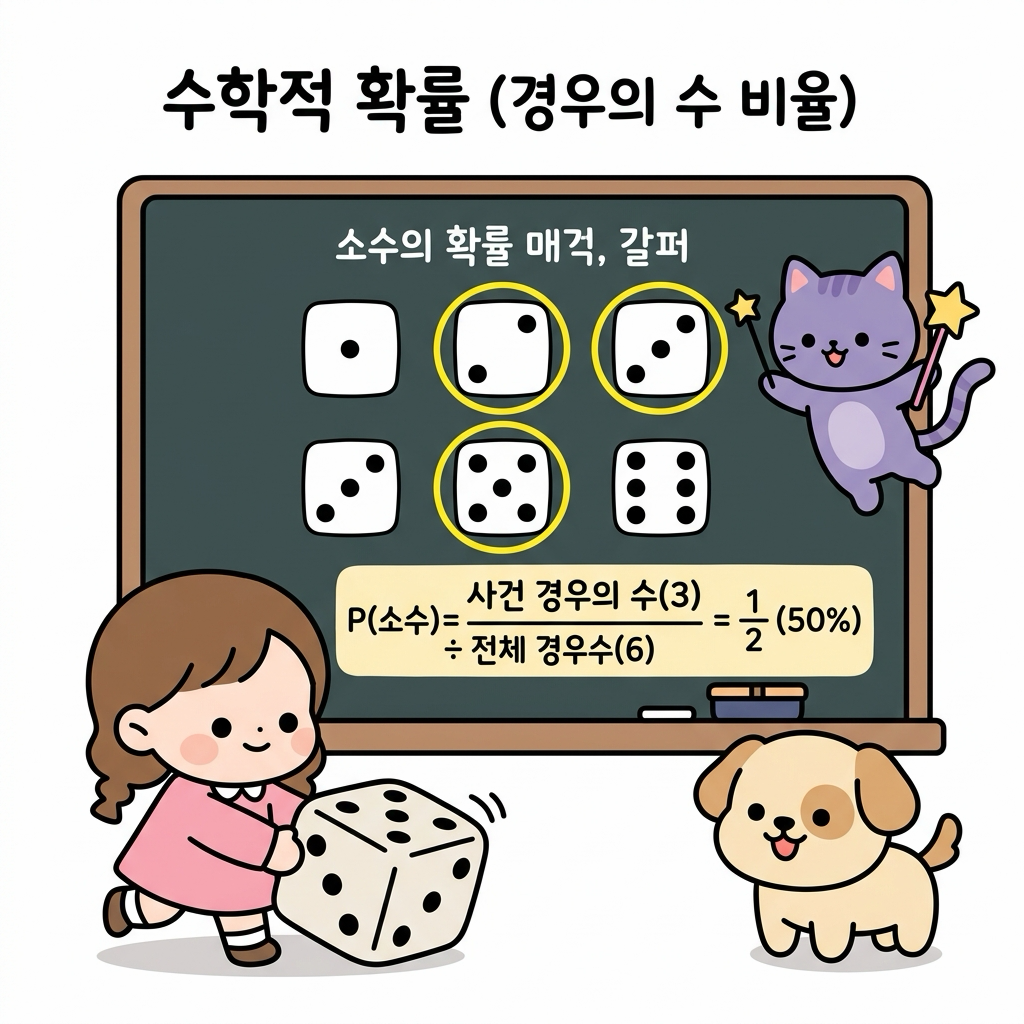 그림 02-9-9 주사위 6개의 면 중 소수(2, 3, 5) 3개의 경우의 수 비율(3/6 = 50%)로 계산하는 수학적(고전적) 확률 유도 원리
2.9.2.2 실험적 확률 (통계적 확률, 경험적 확률)
동일한 조건에서 시행을 N번 독립적으로 반복할 때, 사건 A가 발생한 횟수를 r이라고 하면, 시행 횟수 N이 무한히 커짐에 따라 상대도수(r / N)가 수렴하는 극한값을 뜻합니다.
\[P(A) = \lim_{N \to \infty} \frac{r}{N}\]- 특징: 주사위의 무게중심이 쏠려 있거나 기상 예측, 강화학습 에이전트의 보상 획득률처럼 이론적 계산이 불가능한 현실 데이터의 확률을 측정할 때 사용합니다.
- 💡 강화학습 몬테카를로(Monte Carlo) 기법과의 연계:
- 환경의 내부 전이 확률이나 보상 함수를 수학적으로 정확히 알 수 없는 모델 프리(Model-Free) 강화학습에서는 에이전트가 환경과 직접 수없이 상호작용하며 에피소드를 반복 시행(시뮬레이션)합니다.
- 이때 수많은 에피소드에서 얻은 경험적 보상의 평균을 계산하여 상태의 참 가치(Value)를 점진적으로 추정해 나가는 핵심 방법론이 바로 몬테카를로(Monte Carlo, MC) 예측입니다. 즉, 몬테카를로 기법은 바로 이 실험적(경험적) 확률과 대수의 법칙에 직접적인 수학적 토대를 두고 있습니다.
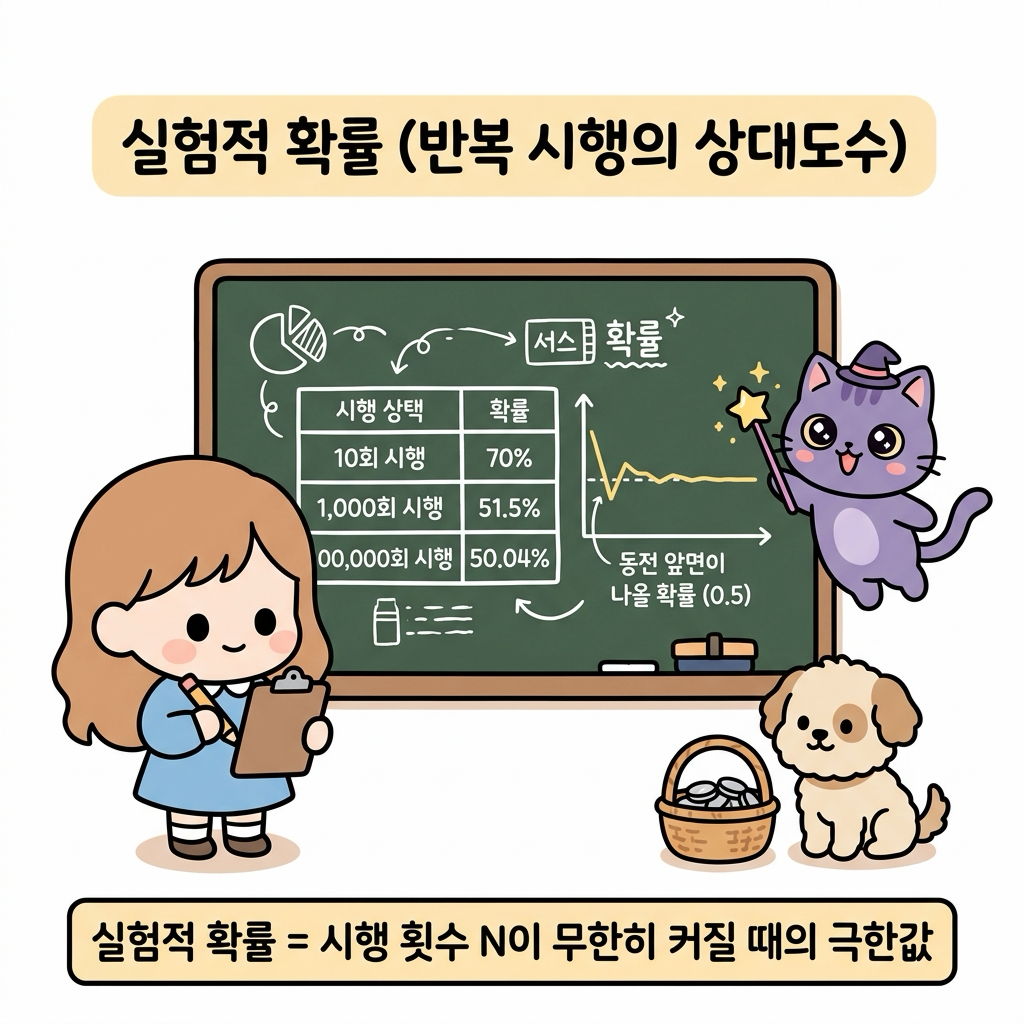 그림 02-9-10 시행 횟수(N)를 거듭할수록 누적 상대도수가 이론적 극한의 참 확률(0.5)에 수렴해가는 실험적(통계적) 확률의 원리와 몬테카를로 샘플링의 기초
2.9.2.3 기하학적 확률 (연속 영역 확률)
경우의 수가 무한히 많은 연속적인 공간(시간, 길이, 면적, 부피)에서 전체 영역 S의 크기 대비 사건 A에 해당하는 영역의 비율로 확률을 정의합니다.
\[P(A) = \frac{\text{사건 } A\text{가 차지하는 영역의 크기(넓이)}}{\text{전체 영역 } S\text{의 크기(넓이)}}\]- 대표 예시: 반지름이 2인 원형 과녁에서 반지름이 1인 정중앙 원을 맞힐 확률: \(P(\text{정중앙}) = \frac{\pi \times 1^2}{\pi \times 2^2} = \frac{1}{4} = 0.25\)
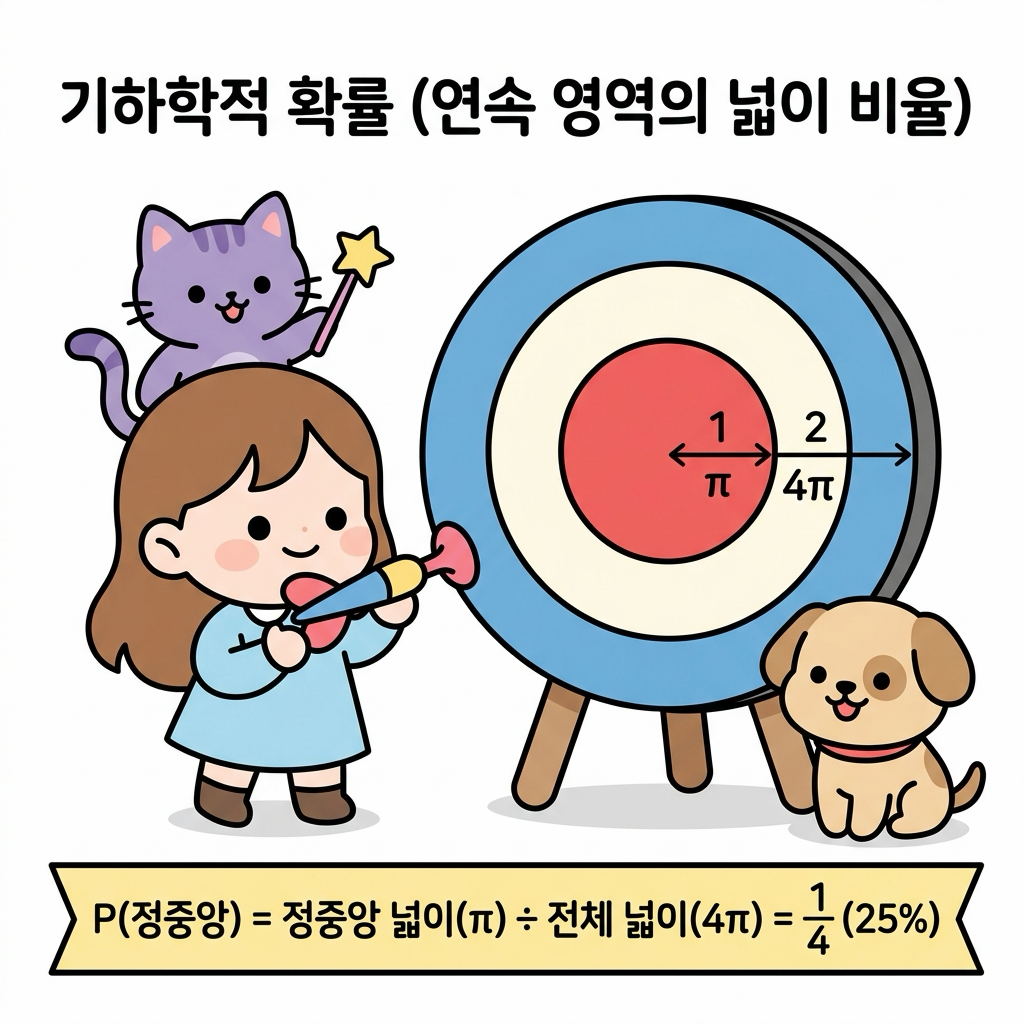 그림 02-9-11 전체 과녁 영역(반지름 2, 넓이 4π) 대비 정중앙 목표 영역(반지름 1, 넓이 π)의 면적 비율(1/4 = 25%)로 구하는 기하학적 확률
02.9.3 대수의 법칙과 표본공간의 수렴
“지니! 동전을 직접 10번 던져봤는데, 앞면이 7번이나 나왔어! 그럼 내 동전은 앞면이 나올 확률이 70%인 거야?”
도로시가 동전들을 손바닥에 올려놓으며 갸우뚱거렸습니다.
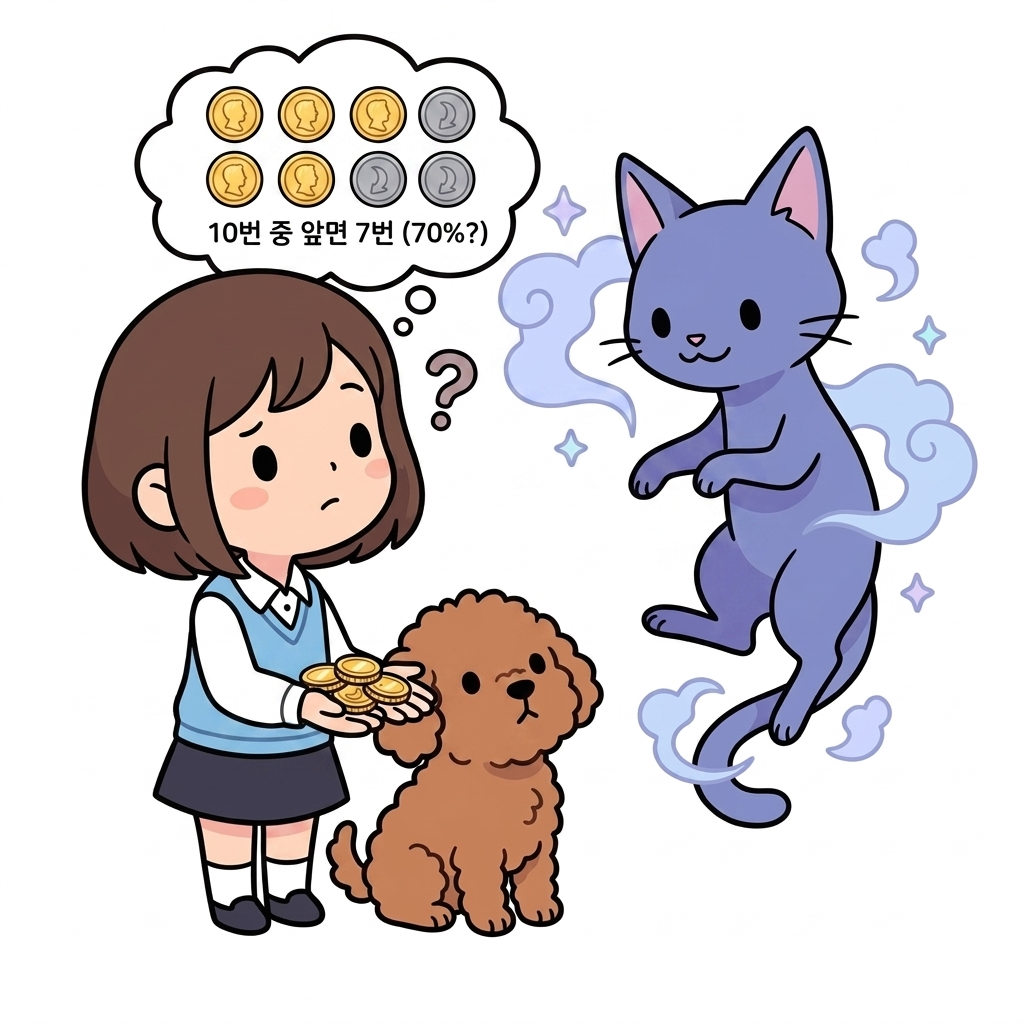 그림 02-9-12 동전을 10번 던져 앞면이 7번 나온 결과를 보고 앞면의 확률이 70%인지 궁금해하는 도로시와 이를 지켜보는 지니, 토토
지니는 허공에 꺾은선 그래프를 띄우며 자상하게 설명했습니다.
“던진 횟수가 적을 때는 우연한 편향이나 노이즈 때문에 비율이 요동칠 수 있단다. 하지만 던진 횟수를 1,000번, 10,000번으로 늘려갈수록 상대도수는 이론적인 참 확률(50%)에 완벽하게 수렴하게 되지. 이걸 수학에서는 대수의 법칙(Law of Large Numbers, 큰 수의 법칙)이라고 부른단다.”
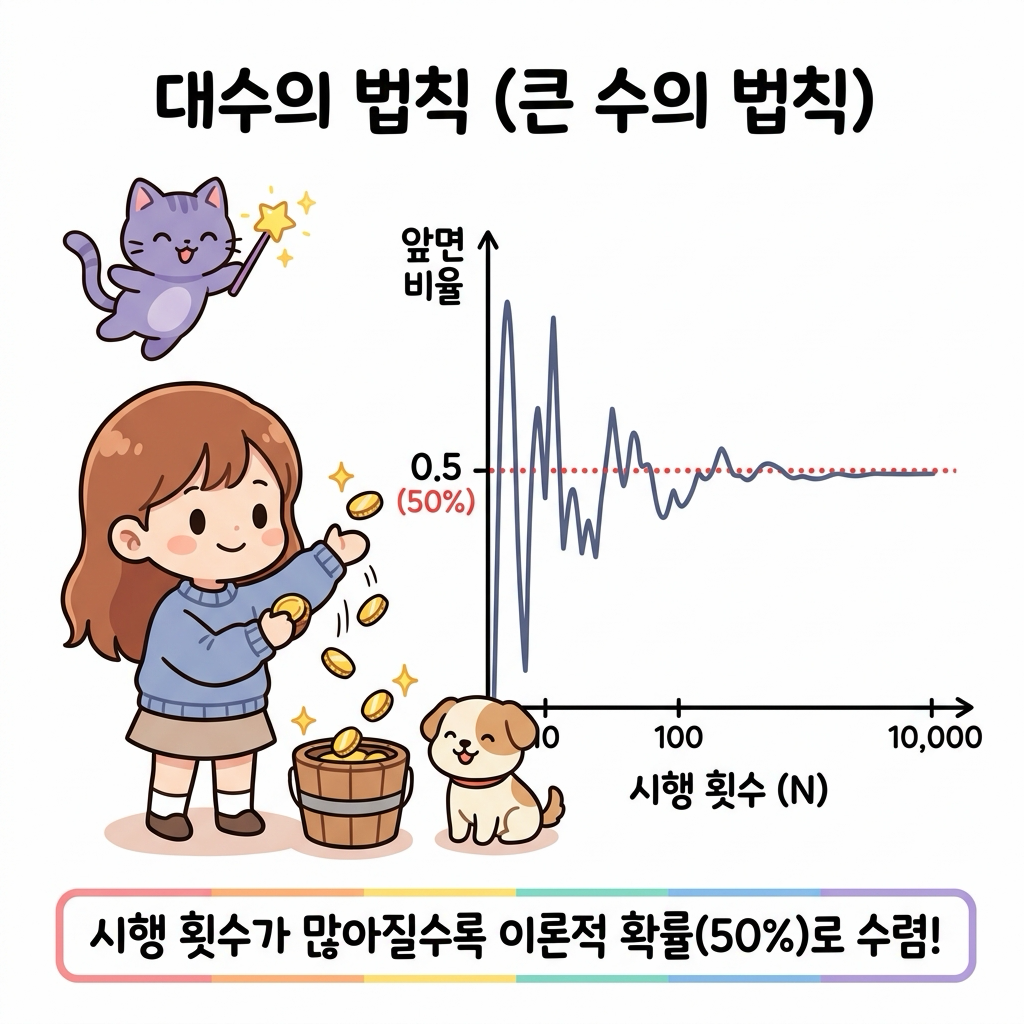 그림 02-9-13 동전 던지기 시행 횟수(N)가 적을 때는 확률 변동이 심하나, 횟수가 만 번에 도달할수록 이론적 참 확률(0.5)로 매끄럽게 수렴하는 대수의 법칙 시뮬레이션
- 수식 기호 및 용어 설명:
- N: 총 시행 횟수 (독립적으로 반복된 동전 던지기 또는 에피소드 수)
- rN: N번의 시행 중 특정 사건(예: 동전 앞면)이 실제로 발생한 횟수
- rN / N: 표본 상대도수 (실험을 통해 직접 관측된 경험적·통계적 확률)
- p: 사건이 일어날 이론적인 참 확률 (공정한 동전의 경우 0.5)
-
** rN / N - p : 경험적 상대도수와 참 확률 사이의 **절대 오차 (오차의 크기) - limN→∞: 시행 횟수 N을 무한히 늘려갈 때의 극한 연산자
- = 0: 시행 횟수가 무한히 커질수록 상대도수와 이론적 참 확률 간의 오차가 0으로 완벽하게 수렴함을 의미
“와! 시행 횟수를 대규모로 누적하면 참 확률에 도달하는구나! 그래서 강화학습에서도 에이전트가 수만 번의 에피소드를 탐험하며 상태 가치를 참값으로 학습해 나가는 거였어!”
도로시가 눈을 반짝이며 고개를 끄덕였습니다.
02.9.4 파이썬으로 구현하는 대수의 법칙 시뮬레이터
파이썬의 random 모듈을 활용하여 동전을 던지는 시행 횟수(N)가 증가함에 따라 앞면이 나올 확률이 이론적 참 확률(0.5)로 수렴하는 과정을 확인합니다.
- 예제 파일: law_of_large_numbers.py
import random

def simulate_law_of_large_numbers(trials_list):
    print("=== 대수의 법칙 동전 던지기 시뮬레이션 ===")
    random.seed(42)  # 재현성을 위한 시드 고정

    for n in trials_list:
        heads_count = 0
        for _ in range(n):
            # 1: 앞면, 0: 뒷면
            if random.randint(0, 1) == 1:
                heads_count += 1

        relative_frequency = heads_count / n
        error = abs(relative_frequency - 0.5)
        print(f"시행 횟수 N = {n:7,d} | 앞면 횟수 = {heads_count:7,d} | "
              f"상대도수 = {relative_frequency:.5f} | 오차 = {error:.5f}")

# 시행 횟수를 10회부터 1,000,000회까지 기하급수적으로 증가
trials = [10, 50, 100, 500, 1000, 10000, 100000, 1000000]
simulate_law_of_large_numbers(trials)
[실행 결과]
=== 대수의 법칙 동전 던지기 시뮬레이션 ===
시행 횟수 N =      10 | 앞면 횟수 =       7 | 상대도수 = 0.70000 | 오차 = 0.20000
시행 횟수 N =      50 | 앞면 횟수 =      29 | 상대도수 = 0.58000 | 오차 = 0.08000
시행 횟수 N =     100 | 앞면 횟수 =      49 | 상대도수 = 0.49000 | 오차 = 0.01000
시행 횟수 N =     500 | 앞면 횟수 =     248 | 상대도수 = 0.49600 | 오차 = 0.00400
시행 횟수 N =   1,000 | 앞면 횟수 =     515 | 상대도수 = 0.51500 | 오차 = 0.01500
시행 횟수 N =  10,000 | 앞면 횟수 =   5,023 | 상대도수 = 0.50230 | 오차 = 0.00230
시행 횟수 N = 100,000 | 앞면 횟수 =  49,944 | 상대도수 = 0.49944 | 오차 = 0.00056
시행 횟수 N = 1,000,000 | 앞면 횟수 = 500,317 | 상대도수 = 0.50032 | 오차 = 0.00032
💡 코드 해석: 시행 횟수 N = 10일 때는 상대도수가 0.70(오차 0.20)으로 요동치지만, N이 1,000,000회에 도달하면 상대도수가 0.50032로 이론적 확률 0.5와의 오차가 0.00032 수준으로 급격히 줄어드는 것을 확인할 수 있습니다.
02.9.5 실전 예제
학습한 내용을 바탕으로 다음 문제를 직접 해결해 봅시다.
2.9.5.1 문제 1 (독립사건과 확률의 곱셈)
서로 다른 두 개의 주사위(빨간색, 파란색)를 동시에 던질 때, 두 주사위의 눈이 모두 4 이하가 나올 확률을 구하시오.
풀이:
- 빨간색 주사위에서 4 이하의 눈(1, 2, 3, 4)이 나올 사건을 A라 하면: \(P(A) = \frac{4}{6} = \frac{2}{3}\)
- 파란색 주사위에서 4 이하의 눈이 나올 사건을 B라 하면: \(P(B) = \frac{4}{6} = \frac{2}{3}\)
- 두 주사위는 서로 영향을 주지 않는 독립사건이므로 곱셈정리를 적용합니다: \(P(A \cap B) = P(A) \times P(B) = \frac{2}{3} \times \frac{2}{3} = \frac{4}{9} \approx 0.4444\ (44.4\%)\) 정답: 4 / 9 (약 44.4%)
2.9.5.2 문제 2 (기하학적 확률과 강화학습 탐색 영역)
한 변의 길이가 10인 정사각형 모험 지도 구역에서, 중심에 위치한 가로 4, 세로 4인 정사각형 ‘보물 상자 구역’에 에이전트가 무작위로 착지할 확률을 구하시오.
풀이:
- 전체 지도 영역 S의 넓이: \(\text{Area}(S) = 10 \times 10 = 100\)
- 보물 상자 구역 A의 넓이: \(\text{Area}(A) = 4 \times 4 = 16\)
- 기하학적 확률 공식에 따라 전체 면적 대비 목표 면적의 비율을 계산합니다: \(P(A) = \frac{\text{Area}(A)}{\text{Area}(S)} = \frac{16}{100} = 0.16\ (16\%)\) 정답: 16% (0.16)
02.9.6 핵심 요약
 그림 02-9-14 전체 확률의 합 1.0 공리, 수학적·실험적·기하학적 확률의 정의, 대수의 법칙 수렴 등 확률의 기본기를 마스터한 도로시와 지니, 토토
- 확률의 공리: 모든 확률값은 0 이상 1 이하의 실수이며(0 ≤ P(A) ≤ 1), 이동 가능한 모든 다음 상태 전이 확률의 총합은 항상 1.0(100%)이다.
- 확률의 3대 정의: 표본공간의 원소 비율로 구하는 수학적 확률, 반복 시행의 극한으로 얻는 실험적 확률, 연속 공간의 면적비로 구하는 기하학적 확률이 있다.
- 대수의 법칙(LLN): 시행 횟수 N이 커질수록 표본 상대도수는 이론적 참 확률에 반드시 수렴한다.
- 독립사건의 곱셈: 서로 영향을 미치지 않는 독립사건들이 동시에 발생할 확률은 각 확률의 단순 곱(P(A ∩ B) = P(A) × P(B))으로 계산한다.
💡 이번 단원 지니의 마법 인사이트
👧 도로시: “아하! 한두 번 미끄러졌다고 실망할 필요 없이, 수천 번 경험을 쌓다 보면 환경의 진짜 전이 확률을 정확하게 파악할 수 있겠네!”
🐱 지니: “정답이야 도로시! 확률의 수학적 성질을 믿고 꾸준히 데이터를 모으는 것이 바로 강화학습 에이전트가 환경을 정복하는 비결이란다!”